
目次 / Step 1 はじめに / Step 2 画像生成の準備
Step 2 画像生成の準備(ComfyUI)
プロンプトから画像まで作るときの準備です。ComfyUI を起動して Pixubus につなぎ、使いたい画面に合わせて画像生成モデルを入れます。プロンプト作りだけなら、このページは飛ばしてかまいません。
2-1 ComfyUI を起動して Pixubus につなぐ
Pixubus が担うのは「作ったプロンプトを ComfyUI に投げて画像を受け取る」部分だけで、モデル本体は ComfyUI 側に入れます。先に ComfyUI を起動しておきます(Pixubus 既定の接続先は http://127.0.0.1:8000)。Pixubus の右上「設定 → ComfyUI」で、接続先 URL の変更と接続テストができます。
ポートは ComfyUI の配布形態と版で違います(ネット上でも情報が錯綜しやすいところです)。接続先を何も設定していなければ、Pixubus は 8000 → 8188 の順に自動で探して、見つかったほうを使います(見つかった先は「設定 → ComfyUI」に出ます)。ポートを変えている・別の PC で動かしている場合は、「設定 → ComfyUI」で URL を入れるか「かんたん切替」ボタンで選んでください。
| ComfyUI の配布形態 | 既定ポート |
|---|---|
| ComfyUI Desktop(インストーラ版) | 8000(古い版)/ 8188(新しい版・2026-11 のクリーンインストール) |
標準版(portable zip / python main.py 手動起動 / RunPod 等) | 8188 |
ComfyUI を別の PC やクラウド GPU で動かすときは、2-7 の「別の PC・クラウド GPU」へ。
2-2 モデルの地図 — どの画面が、どのモデルを使うか
左の「やりたいこと」から右へたどると、入れるテンプレートと、そこで入るファイルが分かります。使わない画面のモデルは入れなくてかまいません。
リファレンス生成・立ち絵差分(表情差分 / 衣装変更)・ポーズ集の 3 つと自然文スタイルは、Anima とは別の、画像と英語の文章を読める画像生成モデルで描きます。参照から作る画面は Qwen-Image 2.1 と P-H3-Image のどちらか一方だけ入れても動きます。迷ったら Qwen-Image 2.1 から入れてください(透過の立ち絵が作れるのはこちらだけです)。
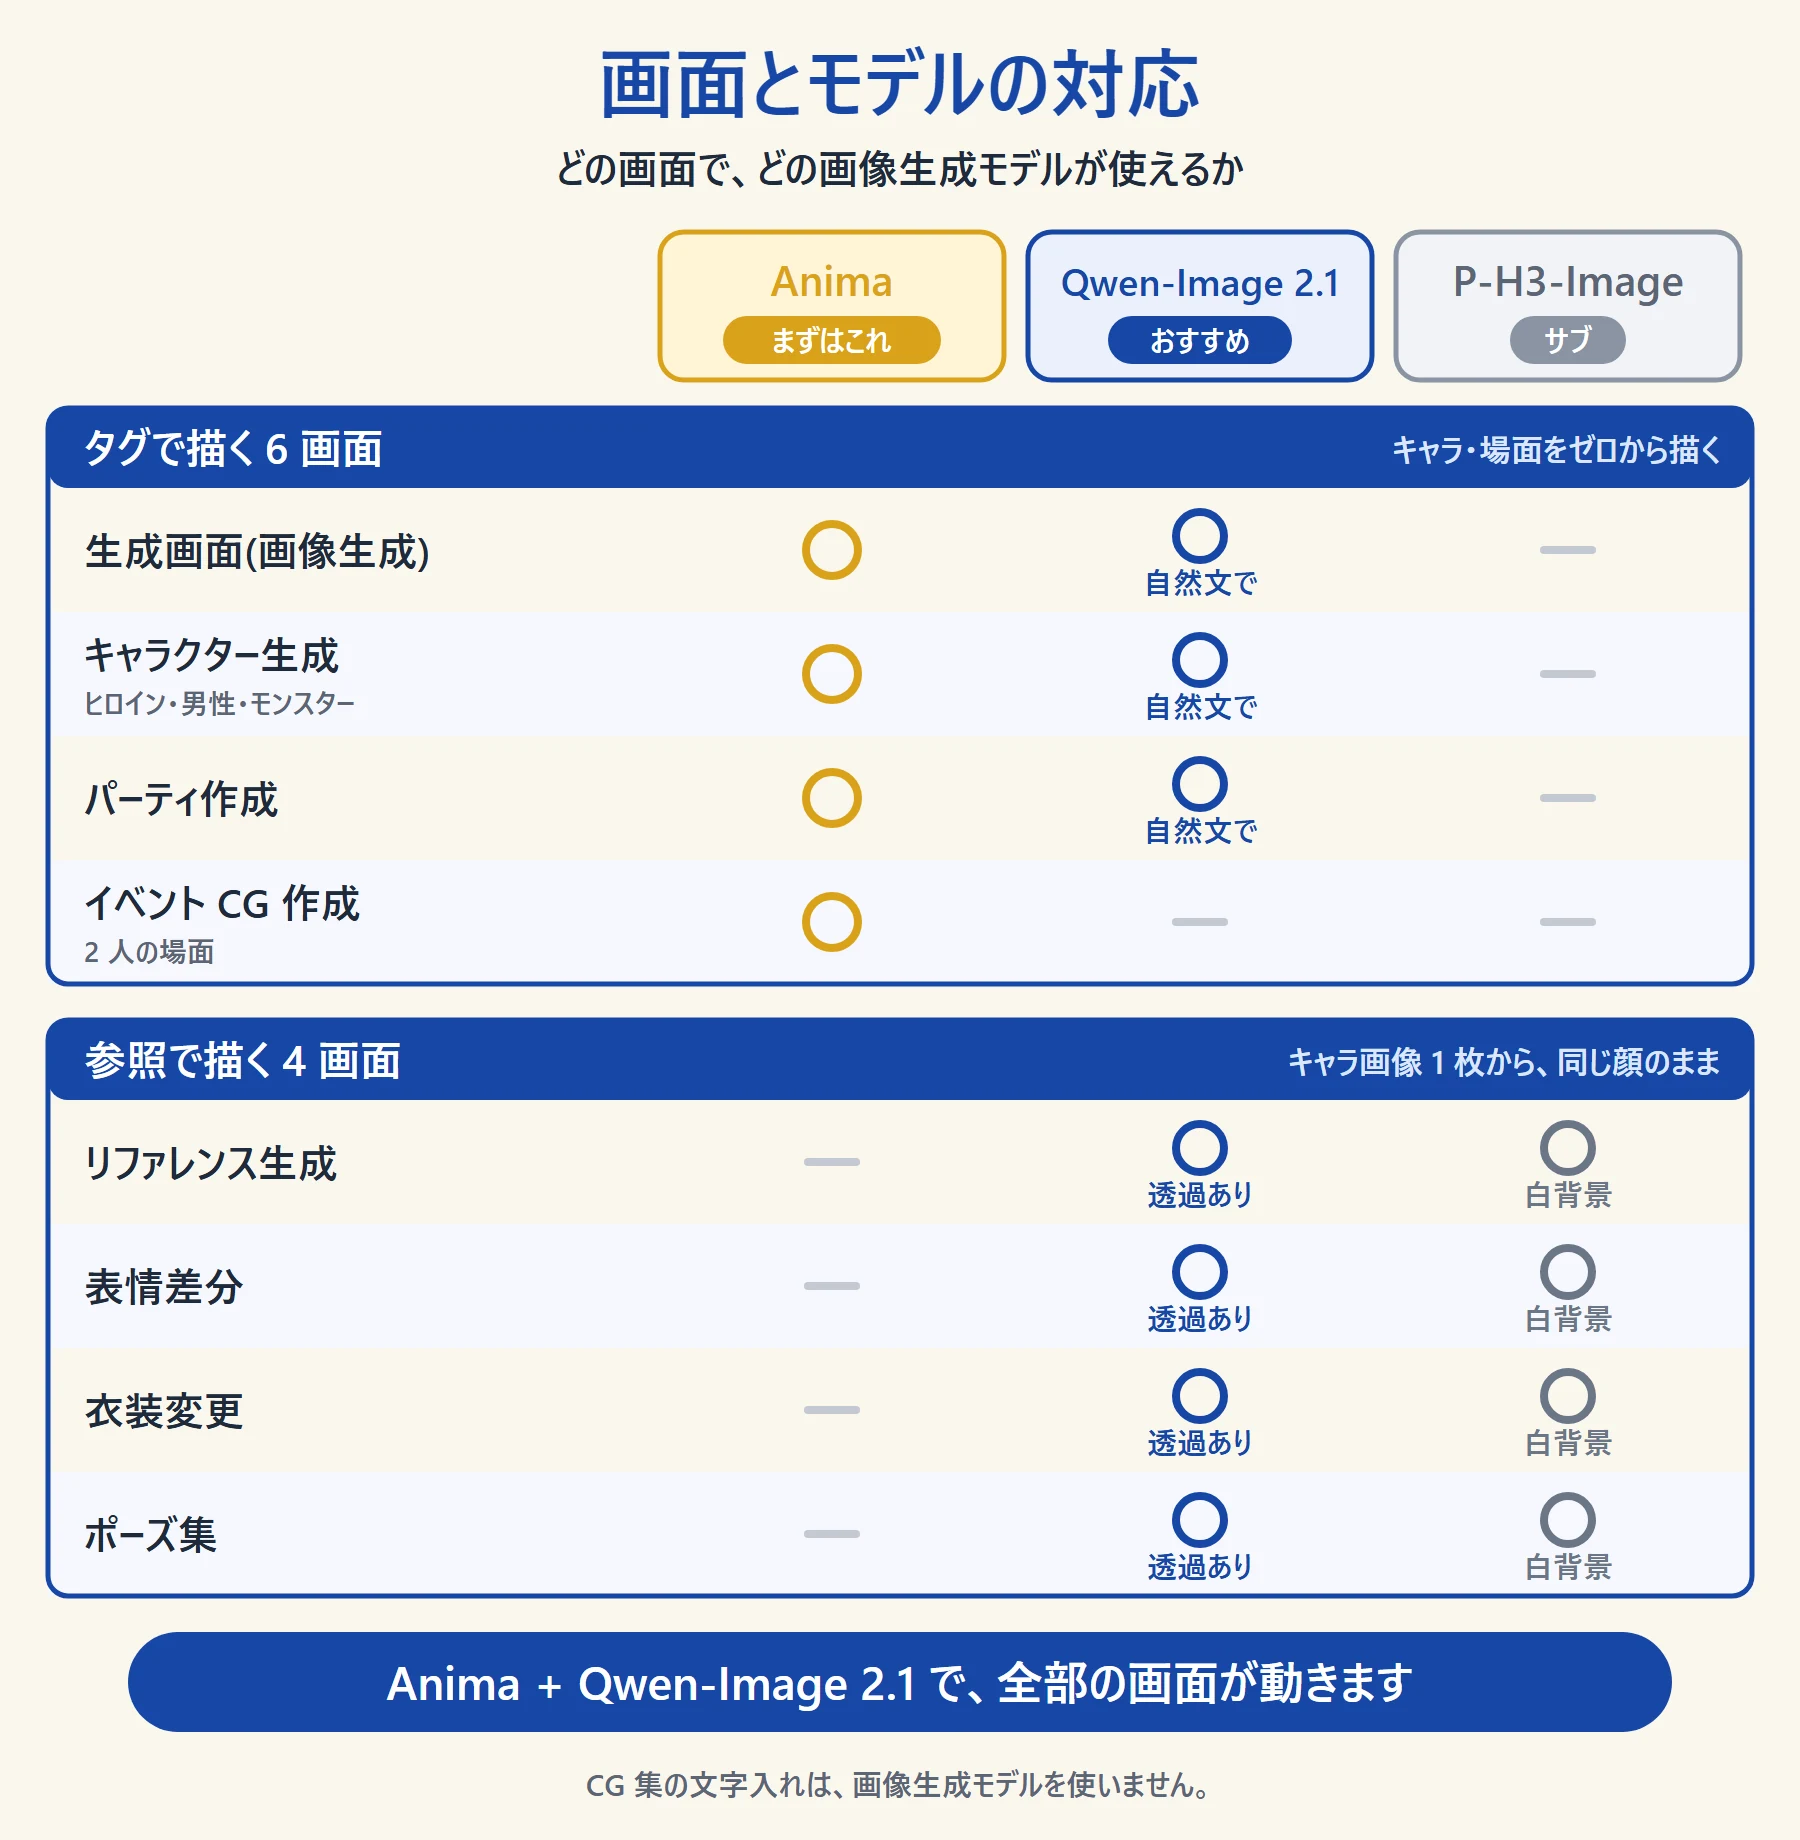
2-3 Anima — タグで描く(既定)
Pixubus の既定ワークフローは Anima(CircleStone Labs と Comfy Org による、アニメ・イラストに特化したモデル)を使います。モデルは ComfyUI のテンプレートから入れるのがいちばん簡単です。ファイルを探しに行く必要はありません。
- ComfyUI の左のサイドバーから「テンプレート」を開き、検索欄に「Anima」と入れます。
- 「Anima Base v1:テキストから画像へ」を開きます。
- 足りないモデルがあると、右に「不足しているモデル」が赤く出ます。「すべてダウンロード」を押せば、必要な 3 ファイルが正しいフォルダに入ります。
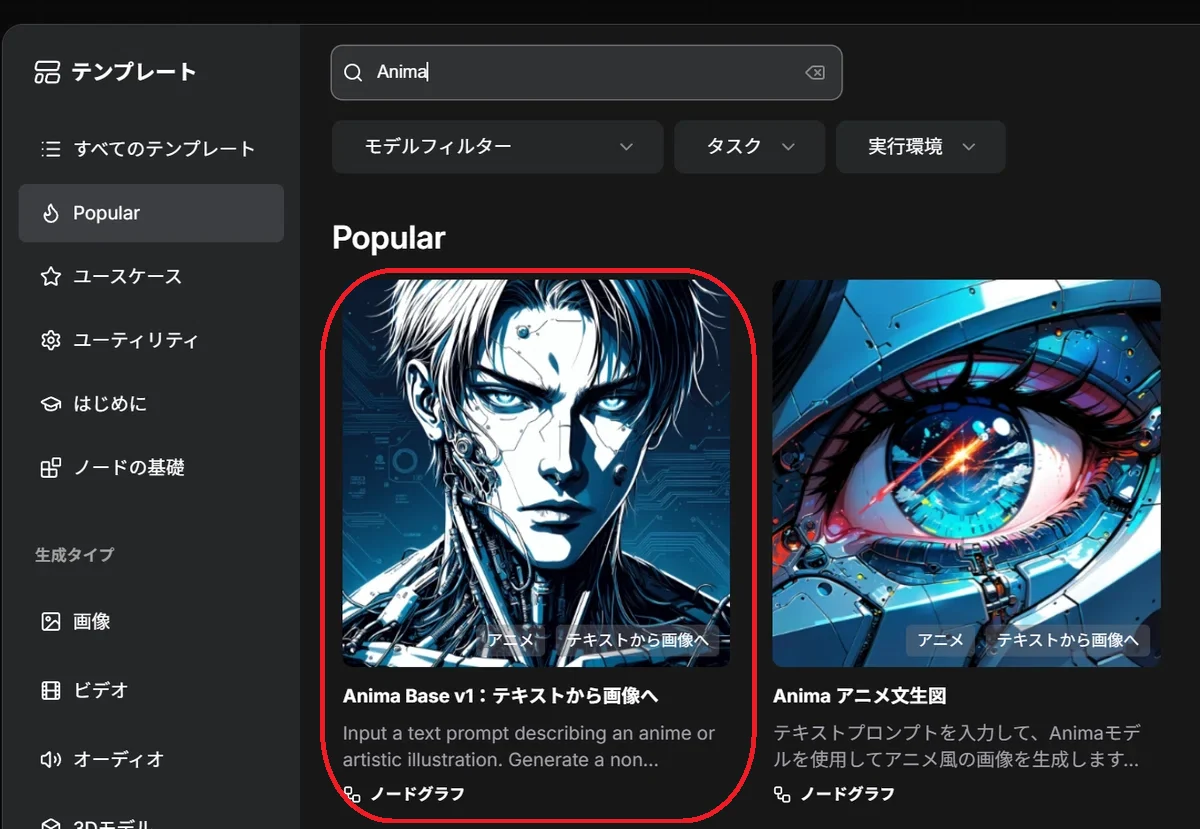
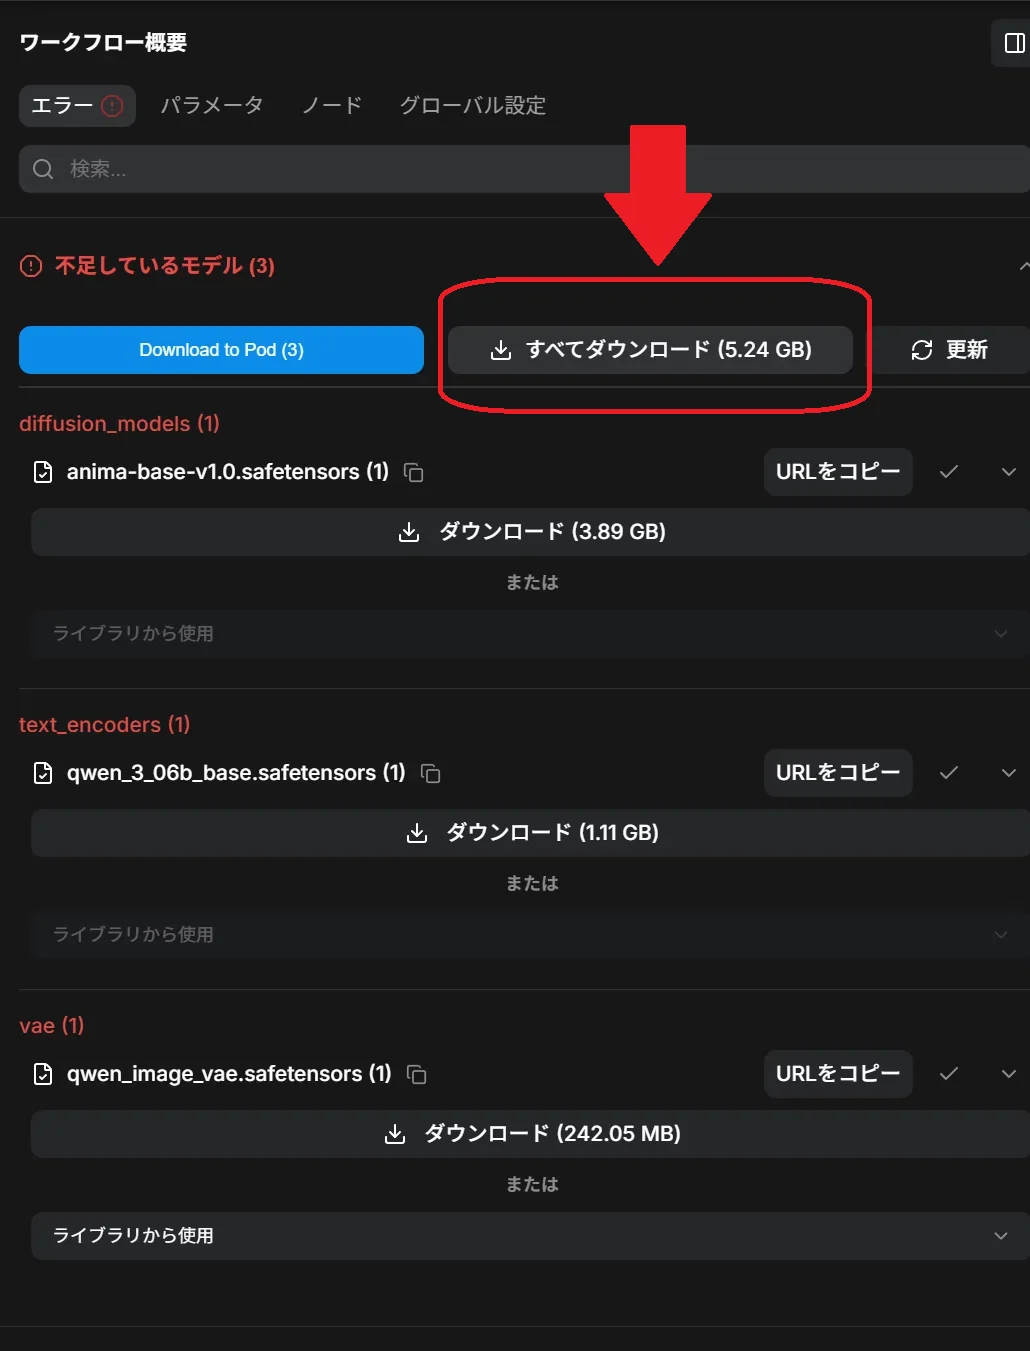
ダウンロードが終わったら、ComfyUI の画面で R キーを押して読み込み直します。これで Pixubus の生成画面のモデル選択で Anima base を選べるようになります。
ターミナルで入れる場合(RunPod などのクラウド GPU・Linux)
入るファイルは次の 3 つです。ComfyUI/models/ の中で次を実行すれば同じものが入ります。
cd ComfyUI/models    # 例: クラウドは /workspace/ComfyUI/models 等、環境に合わせる

wget -c -O diffusion_models/anima-base-v1.0.safetensors \
  "https://huggingface.co/circlestone-labs/Anima/resolve/main/split_files/diffusion_models/anima-base-v1.0.safetensors"
wget -c -O text_encoders/qwen_3_06b_base.safetensors \
  "https://huggingface.co/circlestone-labs/Anima/resolve/main/split_files/text_encoders/qwen_3_06b_base.safetensors"
wget -c -O vae/qwen_image_vae.safetensors \
  "https://huggingface.co/circlestone-labs/Anima/resolve/main/split_files/vae/qwen_image_vae.safetensors"
💡 RunPod などのクラウドでは aria2c(並列ダウンロード)がおすすめです。入っていなければ sudo apt-get install -y aria2(RunPod は root なので sudo は不要)。
# aria2c 版(-x16 -s16 = 16分割で並列DL / -c = レジューム / -d = 保存先 / -o = ファイル名)
aria2c -c -x16 -s16 -k1M -d diffusion_models -o anima-base-v1.0.safetensors \
  "https://huggingface.co/circlestone-labs/Anima/resolve/main/split_files/diffusion_models/anima-base-v1.0.safetensors"
aria2c -c -x16 -s16 -k1M -d text_encoders -o qwen_3_06b_base.safetensors \
  "https://huggingface.co/circlestone-labs/Anima/resolve/main/split_files/text_encoders/qwen_3_06b_base.safetensors"
aria2c -c -x16 -s16 -k1M -d vae -o qwen_image_vae.safetensors \
  "https://huggingface.co/circlestone-labs/Anima/resolve/main/split_files/vae/qwen_image_vae.safetensors"
Turbo を入れる(任意・高速化)
高速生成の「Turbo」ワークフローを使うときだけ必要です。Turbo はテンプレートに無いので、ファイルを手で置きます。使わないなら入れなくてかまいません(標準のワークフローはこれが無くても動きます)。未導入のまま Turbo のワークフローを選ぶと生成に失敗します。
- Turbo v1.1 — Base と同じ Civitai の Anima のページ(CircleStone Labs 公式)で、バージョン「Turbo v1.1」を選んでダウンロードし、
models/diffusion_models/にanima_turboV11.safetensorsの名前で置きます(約 3.9GB)。 - Turbo LoRA(約 3〜4 倍速)— Hugging Face「circlestone-labs/Anima-Official-LoRAs」 から
anima-turbo-lora-v0.2.safetensorsを取得し、models/loras/に置きます。
# Turbo LoRA(base とは別リポ → models/loras/ へ)
wget -c -O ComfyUI/models/loras/anima-turbo-lora-v0.2.safetensors \
  "https://huggingface.co/circlestone-labs/Anima-Official-LoRAs/resolve/main/anima-turbo-lora-v0.2.safetensors"
💡 これも aria2c なら速いです:aria2c -c -x16 -s16 -k1M -d ComfyUI/models/loras -o anima-turbo-lora-v0.2.safetensors "…上と同じ URL…"
2-4 Qwen-Image 2.1 — 参照から作る・自然文
ComfyUI を新しくする
Qwen-Image 2.1 を動かすノードは、新しい ComfyUI にしか入っていません。先に ComfyUI を最新版に上げておきます。
テンプレートからモデルを入れる
Anima と同じく、ComfyUI のテンプレートから入れます。
- ComfyUI の左のサイドバーから「テンプレート」を開き、検索欄に「Qwen Image 2.1」と入れます。
- 出てくる 3 つのうち、真ん中の「Qwen Image 2.1:画像編集」を開きます。
- 右に「不足しているモデル」が赤く出るので、「すべてダウンロード」を押します(3 ファイル・合計 16.1 GB)。
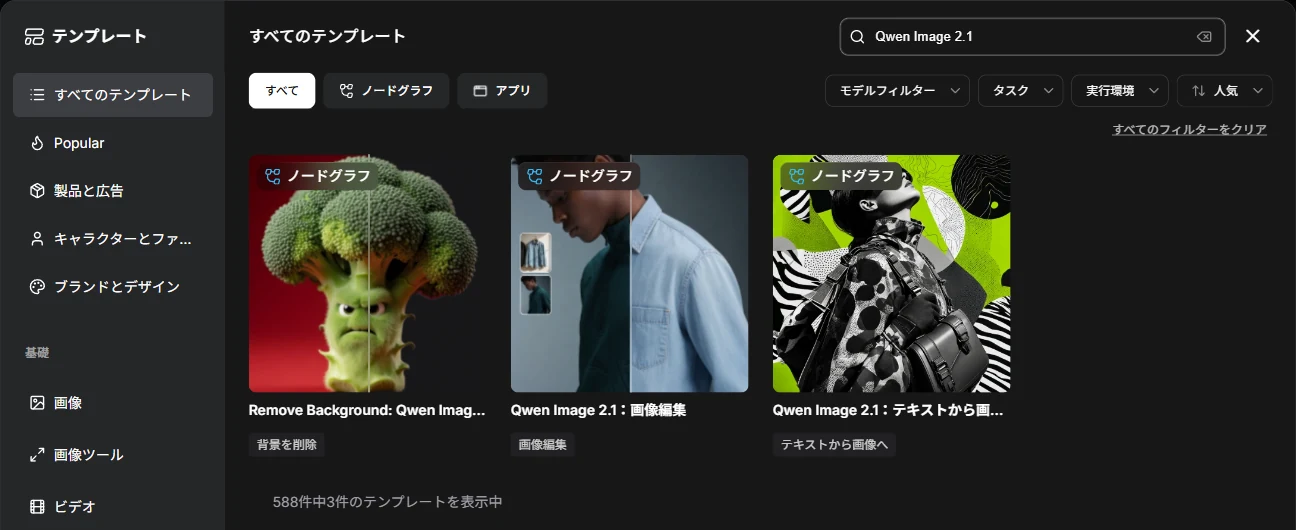
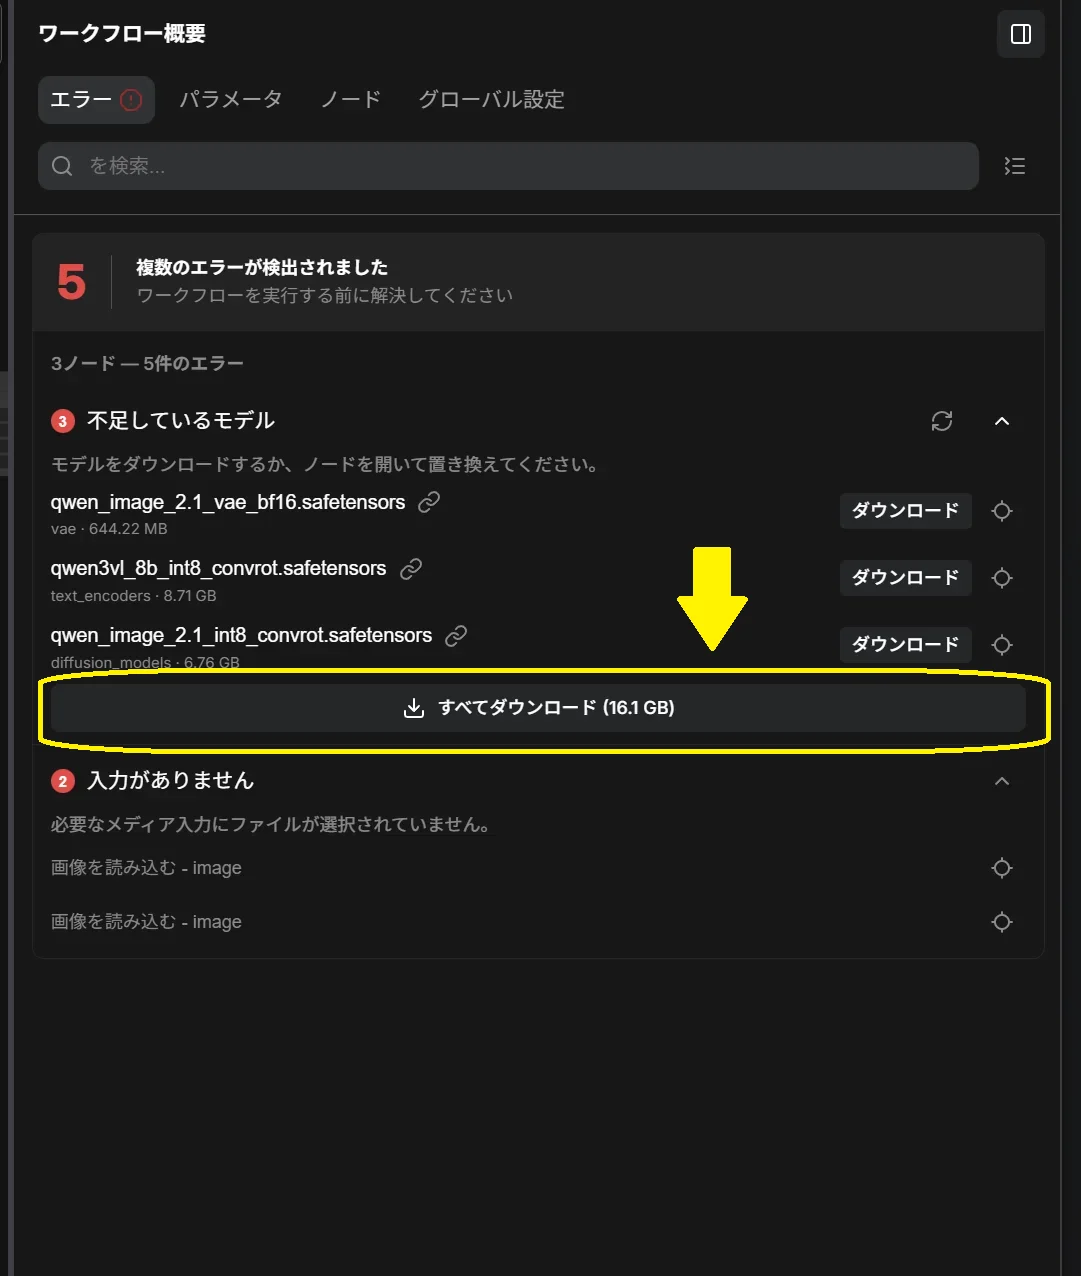
ここで入るのが、同梱のワークフローが読む次の 3 ファイルです。
| ファイル | 置き場所(ComfyUI/models/ 内) | 大きさ |
|---|---|---|
qwen_image_2.1_int8_convrot.safetensors | diffusion_models/ | 6.76 GB |
qwen3vl_8b_int8_convrot.safetensors | text_encoders/ | 8.71 GB |
qwen_image_2.1_vae_bf16.safetensors | vae/ | 644 MB |
ダウンロードが終わったら、ComfyUI の画面で R キーを押して読み込み直します。
ComfyUI だけで動くか確かめる(任意)
「不足しているモデル」の下に「入力がありません」というエラーも出ますが、見本の画像が入っていないだけで、壊れてはいません。「画像を読み込む」に人物の画像と服の画像を 1 枚ずつ入れて「実行する」を押し、1 枚出てくれば ComfyUI 側の準備はできています。
Pixubus から使う
ワークフローは zip に同梱しています(comfyui/api/ の qwen_image_21_ で始まる 2 本)。モデルが入っていれば、次の場所でそのまま選べます。
- リファレンス生成・表情差分・衣装変更・ポーズ集 — ③ のワークフロー欄。モデル欄では、同じ系統の派生モデルに差し替えることもできます。
- 生成画面・キャラクター生成・パーティ作成 — 出力スタイルで「Qwen-Image 2.1(自然文)」を選ぶと、③ のワークフローが自然文用に切り替わります。
2-5 P-H3-Image(MiniMax H3)— 参照から作る
PrunaAI が MiniMax H3 をもとに作った画像生成モデルです。リファレンス生成・立ち絵差分(表情差分 / 衣装変更)・ポーズ集の 3 つで使えます(生成画面・キャラクター生成・パーティ作成には出ません)。ComfyUI Desktop は 0.44.0 以降が必要です。
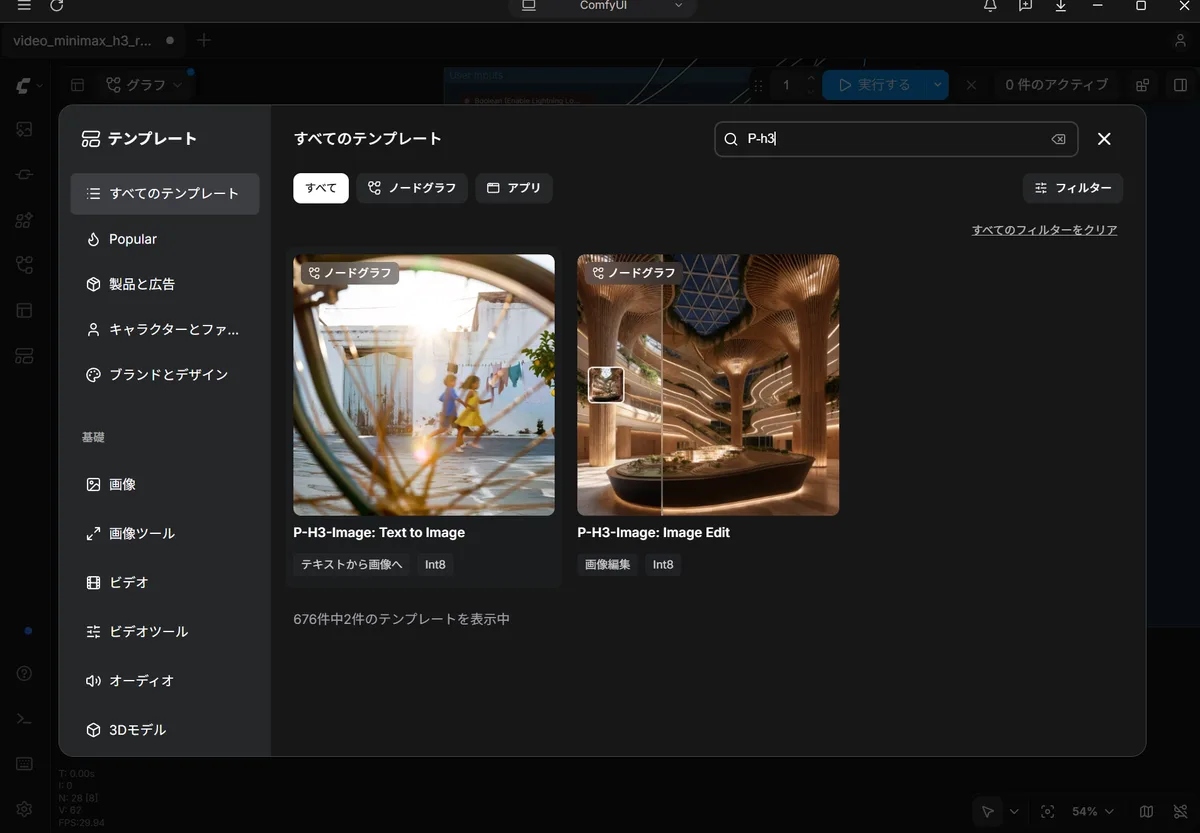
- ComfyUI の「テンプレート」の検索欄に「p-h3」と入れ、「P-H3-Image: Image Edit」(画像編集)を開きます。
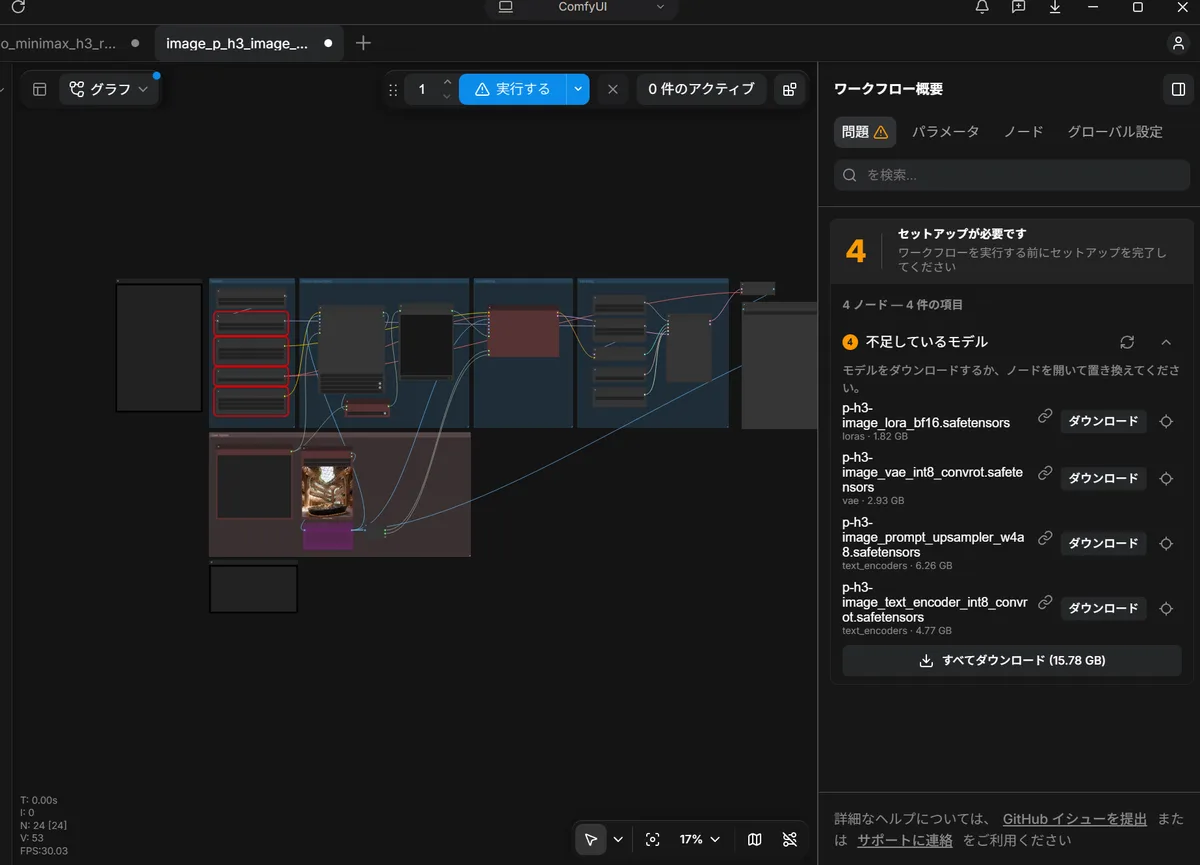
- 右に「不足しているモデル」が出るので、「すべてダウンロード」を押します。ダウンロードが終わったら R キーで読み込み直します。
- Pixubus から使う — ③ のワークフロー欄で「P-H3-Image リファレンス(MiniMax H3・参照 8 枚)」を選びます。参照画像は 8 枚まで。名前に「euler」が付いたもう 1 本はサンプラー違いで、実測では差は seed の揺れ程度です。モデル欄で P-H3-Image の本体(
p-h3-image_で始まるファイル)を選んでもそのまま動きます。 - 背景は白になります — P-H3-Image は透過の PNG を出せません。P-H3-Image を選んでいるあいだは「透過で出す」が消えます。透過の立ち絵が要るときは Qwen-Image 2.1 を使ってください。
- 2 人が絡む場面は Qwen-Image 2.1 のほうが安定します。1 人の絵や衣装変更は P-H3-Image でもよく通ります。
- 時間の目安 — 「参照に合わせる」(既定・約 800 万画素)で 1 枚 35 秒前後。その右の「4MP(速い)」に切り替えると約 400 万画素になり、1 枚 16〜32 秒です(RTX 5070 Ti 16GB + メモリ 64GB・2026-11-06 の実測)。800 万画素のほうが手や細部が崩れにくいので、構図を新しく作るリファレンス生成とポーズ集では既定にしています。参照の絵をもとに一部だけ変える表情差分と衣装変更は、400 万画素でも仕上がりが変わらないので 4MP が既定です(線を細かくしたいときだけ 8MP に)。最初の 1 枚はモデルの読み込みで長くかかります。グラフィックボードのメモリが 16GB だと載り切らない分をメモリに逃がして動くので、メモリは 64GB あると安心です。Mac で動くかは確かめていません。
- テキストエンコーダや VAE を別の版(w4a8 / bf16 など)にしたいときは、
comfyui/api/p_h3_image_ref_pixubus.api.jsonをコピーして名前を変え、中のファイル名を書き換えると、③ のワークフロー欄に並びます。
Ollama と ComfyUI を同じ PC で動かしている場合、このモデルはそれなりに大きいので、グラフィックボードのメモリに入り切らないことがあります。「設定 → ComfyUI」の「VRAM の譲り合い」の「画像生成が終わったら ComfyUI のモデルを降ろす」を入れておくと、生成の前に Ollama 側のモデルをいったん降ろします。逆向き(Ollama を使う前に ComfyUI のモデルを降ろす)は既定で入っています(v3.9)。詳しくは VRAM の譲り合いへ。
2-6 そろったか確かめる
Pixubus の右上「設定 → ComfyUI」を開くと、接続テストの下に「同梱ワークフローのモデル」が出ます。同梱のワークフローが使うファイルが ComfyUI に入っているかを、名前で確かめる欄です。
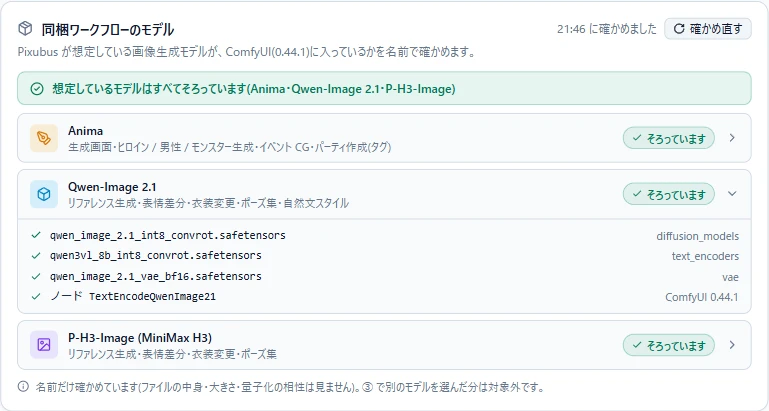
- 足りないと、その行に赤で「N つ足りません」と出ます。行を開くと足りないファイルの名前が赤く並び、「入れ方」のリンクからこのページの該当する節に来られます。
- ComfyUI にモデルを入れたあとは、ComfyUI で R キーを押してから、この欄の「確かめ直す」を押します。
- 使わない画面のモデルは、足りないと出ていてもかまいません。Anima の行は Turbo の 2 本も数えているので、Turbo を入れていなければ「足りません」と出ますが、標準のワークフローは動きます。
2-7 手で置くとき(早見)・別の PC
テンプレートに無いモデル・LoRA を手で置くとき
テンプレートに無いモデルや LoRA(Turbo や、ご自分で選んだ派生モデルなど)は、配布元からダウンロードして手で置きます。ファイルは、種類ごとに ComfyUI の models/ 内の決まったフォルダへ置きます。置いたら ComfyUI 画面で R キー(更新)を押すと、Pixubus の選択肢にも反映されます。
| 種類 | 置き場所(ComfyUI/models/ 内) |
|---|---|
| モデル本体(単体) | diffusion_models/(または unet/) |
| テキストエンコーダ | text_encoders/(または clip/) |
| VAE | vae/ |
| LoRA | loras/ |
| 全部入りチェックポイント | checkpoints/ |
ファイル名は、生成画面のモデル選択やワークフローが参照している名前と一致している必要があります(違う名前で入れたら、画面で選び直すか、ワークフロー側の指定を合わせます)。
別の PC・クラウド GPU(RunPod 等)で動かす
ComfyUI は手元の PC でなく、同じ LAN の別 PC や クラウド GPU サービス(RunPod 等)で動かすこともできます。手順はシンプルです。
- モデル・LoRA はその ComfyUI を動かすマシン側の
models/…に置きます(クラウドなら、ブラウザのターミナルからwgetやaria2c(並列DLで速い)で直接ダウンロードすると速いです)。 - Pixubus の 「設定 → ComfyUI」の接続先 URL を、その ComfyUI のアドレスに変えます。設定画面の 「リモート(RunPod 等)で使うときの URL 例」に、貼り付けるだけの URL 形式(コピー可)を載せています。
クラウドでは、モデルを置く永続ストレージ(RunPod なら Network Volume など)を用意しておくと、インスタンスを停止・作り直してもモデルを置き直さずに済みます。LAN の別 PC につなぐ手順は 別 PC の Ollama / ComfyUI にもあります。
Pixubus はすべてのモデル・ワークフローに対応します(既定で Anima 用 WF を同梱)。自分のワークフローは ComfyUI で「Save (API Format)」して comfyui/api/ に置くと一覧に出ます。ファイル名は ◯◯.api.json にします(独自 WF は未検証=β・出てこないときはこちら)。詳しくは 基本の使い方 の ComfyUI の項目へ。
準備ができたら 基本の使い方 へ。